 Gloria Maria
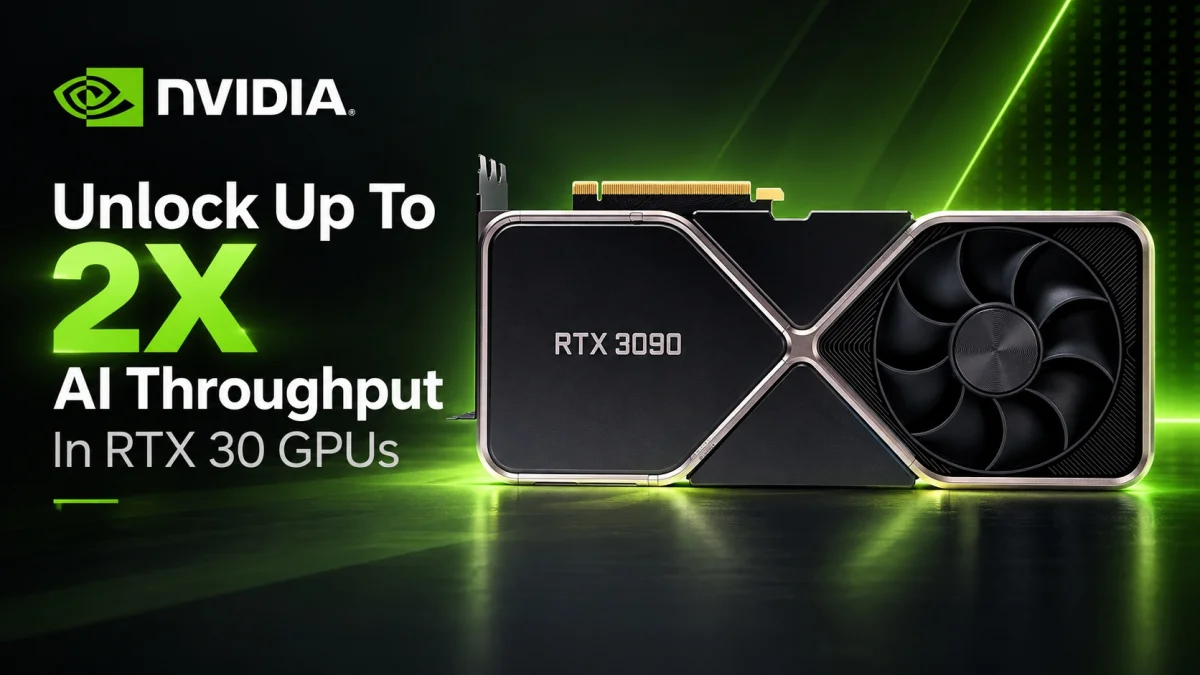
GeForce RTX 30 Series — Uma iniciativa comunitária chamada GPU Unlock revela que placas Ampere podem entregar muito mais poder de cálculo para tarefas de IA sem exigir flash de VBIOS ou drivers modificados. O ponto crítico: liberar uma limitação de taxa de instruções em Tensor Cores pode transformar o uso doméstico dessas GPUs em cenários de inference e geração de imagens.
Como o mod desbloqueia mais desempenho
O GPU Unlock atua sobre a limitação de issuance que reduz a taxa de FP16/BF16 com acumulação em FP32 nas placas Ampere. A solução utiliza um módulo de kernel que roda antes do driver, ajusta seletores de velocidade do hardware e executa um Function Level Reset para que o driver padrão inicialize normalmente.
O suporte listado inclui GPUs baseadas em GA102, GA103, GA104 e GA106 — abrangendo boa parte da linha GeForce RTX 30 Series — e dispensa a necessidade de alterações permanentes no firmware da placa.
GPU Unlock remove a limitação de emissão de instruções FP16/BF16 em Ampere, com um RTX 3090 Ti passando de 42,58 para 82,61 TFLOPS em TF32 e de 87,5 para 157,41 TFLOPS em BF16 durante testes de GEMM.
Ganho em aplicações reais e limites práticos
Em testes reais de comunidade, melhorias substanciais apareceram em workflows de geração de imagem: um usuário relatou 58,6% a mais de throughput no ComfyUI usando MOSS-Image SFT em BF16 num RTX 3090 Ti, e ganhos próximos de 56–59% com outros modelos BF16. Relatórios para RTX 3080 mostraram aumentos de BF16 de ~71,59 para 113,98 TFLOPS em certos casos.
 AMD Zen 6 mostra até 24% mais desempenho por clock
Leia a matéria completa →
 Intel Core Ultra 9 4995HX lidera Nova Lake com 28 núcleos
Leia a matéria completa →
 GeForce RTX 5080 e 5070 Ti: preços sobem até US$300
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Para inferência de LLMs, a melhora é mais variável: houve um relatório de 33% a mais em throughput de prompt-processing no vLLM com RTX 3090, enquanto a geração de tokens permaneceu praticamente inalterada — reflexo de gargalos como largura de banda de memória que não são resolvidos pelo mod.
Existem também implementações experimentais para Windows baseadas em UEFI que documentaram ganhos (por exemplo, ~82,5% em BF16 no RTX 3090 em um teste), mas elas são específicas de hardware e ainda não constituem uma solução universal.
Importante: o GPU Unlock não aumenta largura de banda de memória, nem adiciona núcleos CUDA; resultados dependem do perfil do workload e da compatibilidade da placa — há relatos de procedimentos que não geraram o ganho esperado em algumas RTX 3080 Ti.
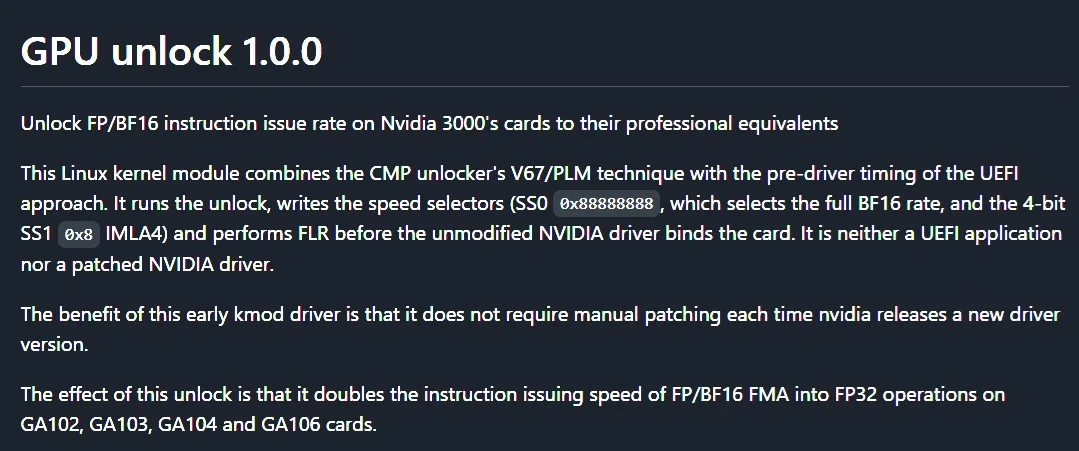 Foto: Divulgação
O que você acha? Você considera usar uma solução desse tipo para extrair mais performance do seu PC? Para acompanhar mais, acesse nossa editoria.
Perguntas Frequentes
O que é o GPU Unlock e como ele afeta as GeForce RTX 30 Series?
O GPU Unlock é um projeto open-source que altera a limitação de emissão de instruções FP16/BF16 nas GPUs GeForce RTX 30 Series, usando um módulo de kernel que roda antes do driver. A técnica permite que placas Ampere atinjam taxas de Tensor Core próximas às de modelos profissionais, sem flash de VBIOS.
Quanto de ganho real posso esperar em aplicações como geração de imagem ou inferência?
As GeForce RTX 30 Series podem ver ganhos reais de throughput em IA: benchmarks comunitários reportaram até 58,6% a mais no ComfyUI com MOSS-Image SFT BF16 em um RTX 3090 Ti, e um relatório mostrou TF32 subindo de 42,58 para 82,61 TFLOPS em testes GEMM com o mesmo modelo.
O GPU Unlock melhora desempenho em jogos e tecnologias como DLSS?
Não há evidência convincente de que o GPU Unlock aumente FPS ou acelere DLSS. As instruções beneficiadas precisam ser usadas pelo workload para gerar vantagem; jogos normalmente não dependem dos mesmos caminhos de Tensor Core usados em workloads de IA, e a largura de banda de memória permanece inalterada.