Marcos Antonio
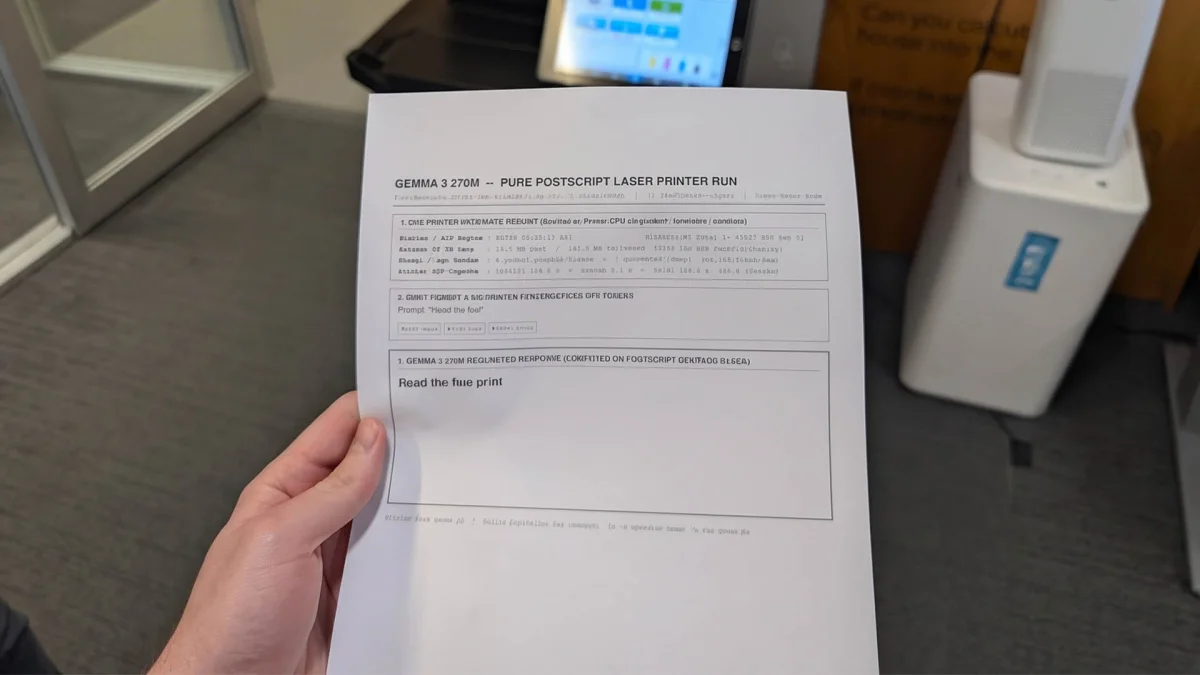
Gemma 3 270M — a demonstração expõe o quanto modelos menores podem realizar inferência local mesmo em equipamentos comuns, transformando impressoras de escritório em plataformas de teste para IA. O resultado desafia suposições sobre requisitos mínimos de memória e abre pista para aplicações de inferência em dispositivos com recursos restritos.
Como a execução aconteceu dentro da impressora
A execução do Gemma 3 270M ocorreu sem modificações no firmware e sem placas de processamento externas: toda a lógica foi empurrada via um arquivo PostScript. O experimento utilizou o Carbon, um motor de inferência leve, combinado a uma versão quantizada do modelo de 270M parâmetros.
Para driblar o limite de memória da máquina, foi aplicado streaming dinâmico de camadas, que carregava e descarregava partes do modelo durante a inferência, mantendo o pico de uso em 14,1MB dentro dos 244,6MB de RAM virtual PostScript alocados.
"Com a ajuda do Carbon, eu executei o Gemma diretamente em uma impressora de escritório."
Desempenho observado e resultado final
O processamento ocorreu no interpretador PostScript Level 3 da impressora, distribuído por 18 camadas de transformer. O sistema relatou 61,3 tokens por segundo durante a geração, e a etapa de prefill para um prompt de quatro tokens levou 184 segundos, com 0,1 segundo na decodificação de cada token gerado.
 Galaxy A08: bateria de 6.000 mAh amplia autonomia e supera A07
Leia a matéria completa →
 iPhone 17 com parcelas de R$ 139 na Multi Friday da Claro
Leia a matéria completa →
 Qualcomm valida HBC: silício promete 18x mais banda de memória
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Ao fim da rotina, a impressora imprimiu fisicamente a resposta completa — a saída traduzida correspondeu à frase final equivalente a "Leia as letras miúdas" — comprovando que tanto a entrada quanto a saída circularam inteiramente pelo stack PostScript.
O caso soma-se a outras experiências com modelos compactos em hardware inesperado e reforça que otimizações de quantização e gerenciamento de memória tornam plausível rodar LLMs menores em equipamentos do dia a dia.
 Foto: Divulgação
O que você acha? Você acredita que impressoras de escritório podem se tornar plataformas práticas para inferência local de IA? Para acompanhar mais, acesse nossa editoria.
Perguntas Frequentes
Como o Gemma 3 270M foi executado dentro de uma impressora sem modificar o hardware?
O Gemma 3 270M foi executado inteiramente via PostScript, usando um arquivo de impressão que invocou o motor de inferência Carbon e o modelo quantizado. O truque técnico foi o streaming dinâmico de camadas, que manteve o pico de RAM em 14,1MB dentro da memória virtual PostScript disponível.
Qual desempenho o Gemma 3 270M alcançou na impressora e quanto tempo levou o processamento?
O Gemma 3 270M alcançou 61,3 tokens por segundo na CPU da impressora, com a inferência distribuída por 18 camadas de transformer. A etapa de prefill para o prompt de quatro tokens levou 184 segundos, e a decodificação de cada token gerado consumiu cerca de 0,1 segundo.
O que exatamente o Gemma 3 270M imprimiu e como foi o resultado físico?
O Gemma 3 270M imprimiu fisicamente a resposta final após a execução no PostScript Level 3 do dispositivo; a saída foi uma frase de três palavras equivalente a "Leia as letras miúdas". O experimento comprovou que todo o ciclo de inferência e impressão ocorreu nativamente dentro da impressora.