 Mariana Costa
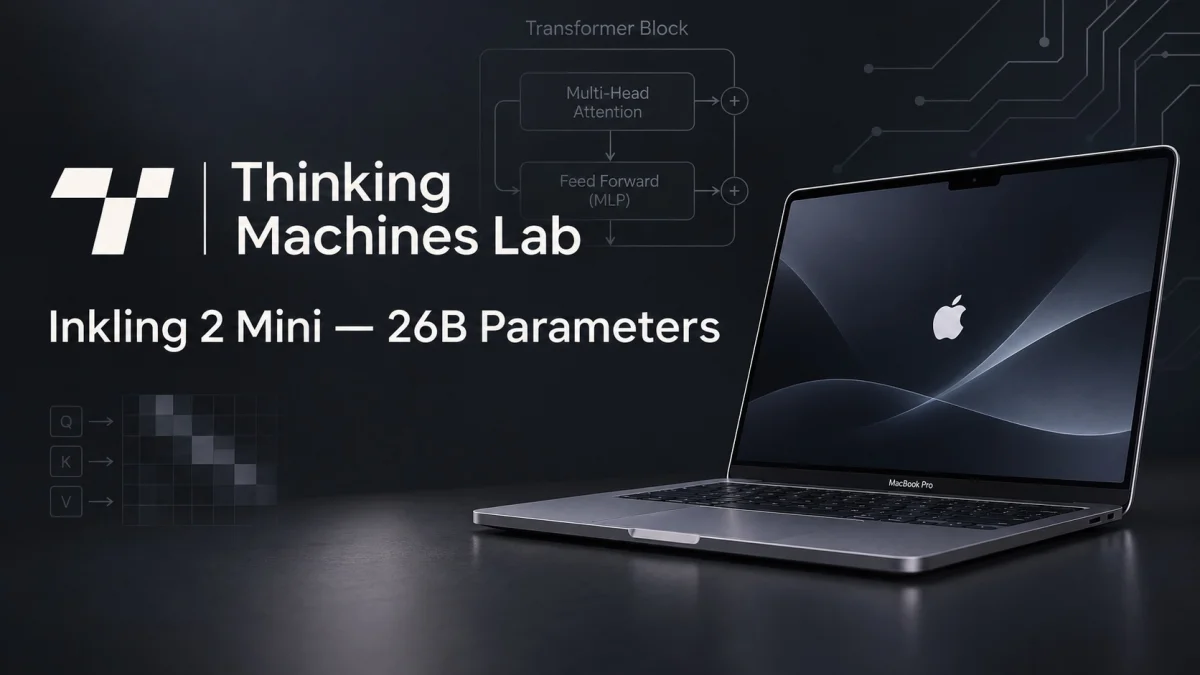
Inkling 2 Mini — o novo modelo open-weight de 26,4 bilhões de parâmetros foi anunciado em 20 de novembro e chama atenção por rodar localmente em máquinas de consumo, incluindo MacBooks com 32GB de memória unificada. A novidade não é apenas a acessibilidade: a arquitetura em loop promete mais raciocínio por token, mudando o patamar de execução offline e reacendendo debates sobre monitorabilidade de modelos avançados.
Arquitetura em loop: mais passes, mais raciocínio
O Inkling 2 Mini utiliza uma arquitetura Mixture of Experts com 24 camadas, mas aplica o bloco central de 12 camadas três vezes, totalizando 48 aplicações de camada por token. Na prática, isso eleva o gasto computacional efetivo por token sem multiplicar proporcionalmente a memória de pesos.
Esse desenho resulta em uma contagem ativa de parâmetros por token de cerca de 5,4 bilhões e, em benchmarks, o modelo registrou 48,2% no DeepSWE v1.1 e 77,9% no SWE-bench Pro v2 Hard, desempenho competitivo frente a modelos maiores.
O modelo ocupa aproximadamente 20GB de memória para execução local, processa entradas de texto e imagem e suporta uma janela de contexto de até um milhão de tokens.
Offline em MacBooks, demonstrações e desafios de segurança
Apesar do porte, o Inkling 2 Mini tem pegada de memória reduzida — cerca de 20GB — o que permite execução em Apple silicon com 32GB de memória unificada via ferramentas de implantação local. Em demonstração, o modelo rodou offline em um MacBook Pro M5 Pro com 48GB e gerou um simulador jogável em poucos minutos.
 Amazon: NuPay lança cupom de 40% na primeira compra
Leia a matéria completa →
 GTA 6: Ryzen 5 5600, RX 7600 e o que evitar ao montar um PC barato
Leia a matéria completa →
 AMDLSS5 2.5: RX 9070 XT roda Resident Evil Requiem 10% mais rápido
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Ao mesmo tempo, a técnica de reuso de camadas levantou preocupação técnica: testes com modelos de loop variável mostraram que múltiplas passagens aumentam a capacidade de resolver problemas sem produzir um encadeamento explícito de raciocínio. Esse "no-chain-of-thought" expandiu de 16 segundos para 37 segundos conforme o número de passes, embora relatórios de experimento indiquem que a razão escrita permaneceu inteligível nessa escala.
O que você acha? Você acredita que modelos como o Inkling 2 Mini, capazes de rodar localmente em máquinas pessoais, mudam a relação entre desenvolvedores e infraestrutura em nuvem? Para acompanhar mais, acesse nossa editoria.
 Foto: Divulgação
Perguntas Frequentes
O que é o Inkling 2 Mini e quais são suas capacidades principais?
Inkling 2 Mini é um modelo open-weight de 26,4 bilhões de parâmetros projetado para tarefas de codificação, raciocínio e cargas agentivas. Anunciado em 20 de novembro, ele combina um Mixture of Experts de 24 camadas com passagens repetidas que ampliam o raciocínio por token, alcançando 48,2% no DeepSWE v1.1 e 77,9% no SWE-bench Pro v2 Hard.
Como é possível rodar o Inkling 2 Mini localmente em um MacBook?
Inkling 2 Mini roda localmente em Macs com pelo menos 32GB de memória unificada porque seu footprint de inferência é cerca de 20GB; a execução local foi demonstrada em um MacBook Pro M5 Pro com 48GB. O modelo tem suporte a implantação via bibliotecas e plataformas de execução local e oferece uma janela de contexto de até um milhão de tokens.
O Inkling 2 Mini levanta riscos de monitorabilidade ou controle?
Pesquisas com arquitetura de loop mostraram que o Inkling 2 Mini e modelos de loop variável podem aumentar o chamado horizonte de "no-chain-of-thought" de 16 para 37 segundos, o que significa mais resolução interna antes de gerar saídas escritas. Testes também indicaram que, na escala avaliada, a razão escrita permaneceu compreensível, embora haja limitações em conversas multi-turno complexas.