 Beatriz Farias
Master Road X10 — A Mechrevo posiciona seu novo mini PC como uma solução para superar limites tradicionais de memória ao rodar modelos de IA localmente, prometendo reduzir carregamentos redundantes e manter contexto entre sessões. O impacto, se cumprido, seria tornar máquinas compactas capazes de executar redes consideravelmente maiores sem depender apenas do DRAM.
Plataforma RTX Spark e especificações máximas
O Master Road X10 se apoia na plataforma RTX Spark da Nvidia, que combina um CPU Grace de 20 núcleos com uma GPU Blackwell de até 6.144 núcleos CUDA. A arquitetura também prevê suporte a até 128 GB de memória unificada LPDDR5X, números que representam os tetos da plataforma.
Essas cifras ainda não foram confirmadas pela Mechrevo para a configuração final do mini PC; portanto, a capacidade exata de memória, o formato do armazenamento e a escolha final de CPU/GPU podem variar no produto comercial.
A fabricante afirma que a AI SSD permite rodar modelos com 80, 120 e 122 bilhões de parâmetros, além de preservar contexto entre sessões.
AI SSD: promessa, testes e limitações técnicas
A peça central do anúncio é a SSD com tecnologia específica para IA, projetada para descarregar partes de modelos do DRAM para a memória NAND e reutilizar contextos já processados, o que reduziria overheads de recarga de modelos. Em apresentação de setembro, a empresa relatou ganhos teóricos como aumento de até 5,7 vezes na carga de modelos suportados e aceleração de até 95% na etapa de prefill.
 The Walking Dead: Aftermath traz Rick Grimes e Daryl Dixon de volta
Leia a matéria completa →
 Red Dead Redemption 2 ganha download grátis por tempo limitado
Leia a matéria completa →
 Super Mario Galactic Wonder parece o melhor Mario em anos
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Em testes de laboratório citados pela fabricante, um notebook Mechrevo Yaoshi 15 Air teria mostrado quase o dobro de velocidade de inferência em algumas condições. Ainda assim, não foram publicados benchmarks detalhados, configurações de quantização de modelos ou condições de teste, o que deixa interrogações sobre reproducibilidade e desempenho em cenários reais.
Há uma limitação técnica óbvia: NAND é significativamente mais lento que DRAM. Isso implica que, mesmo acomodando modelos maiores, a simples presença de uma AI SSD não garante inferência mais rápida; ganhos dependem do mecanismo de cache, da predição de acesso e do equilíbrio entre leitura de SSD e uso da memória unificada.
Capacidade do SSD, opções de conectividade, configurações de memória finais, preço e data de lançamento do Master Road X10 permanecem sem divulgação. Será decisivo ver testes independentes que mostrem como o sistema equilibra latência, throughput e persistência de contexto em cenários práticos.
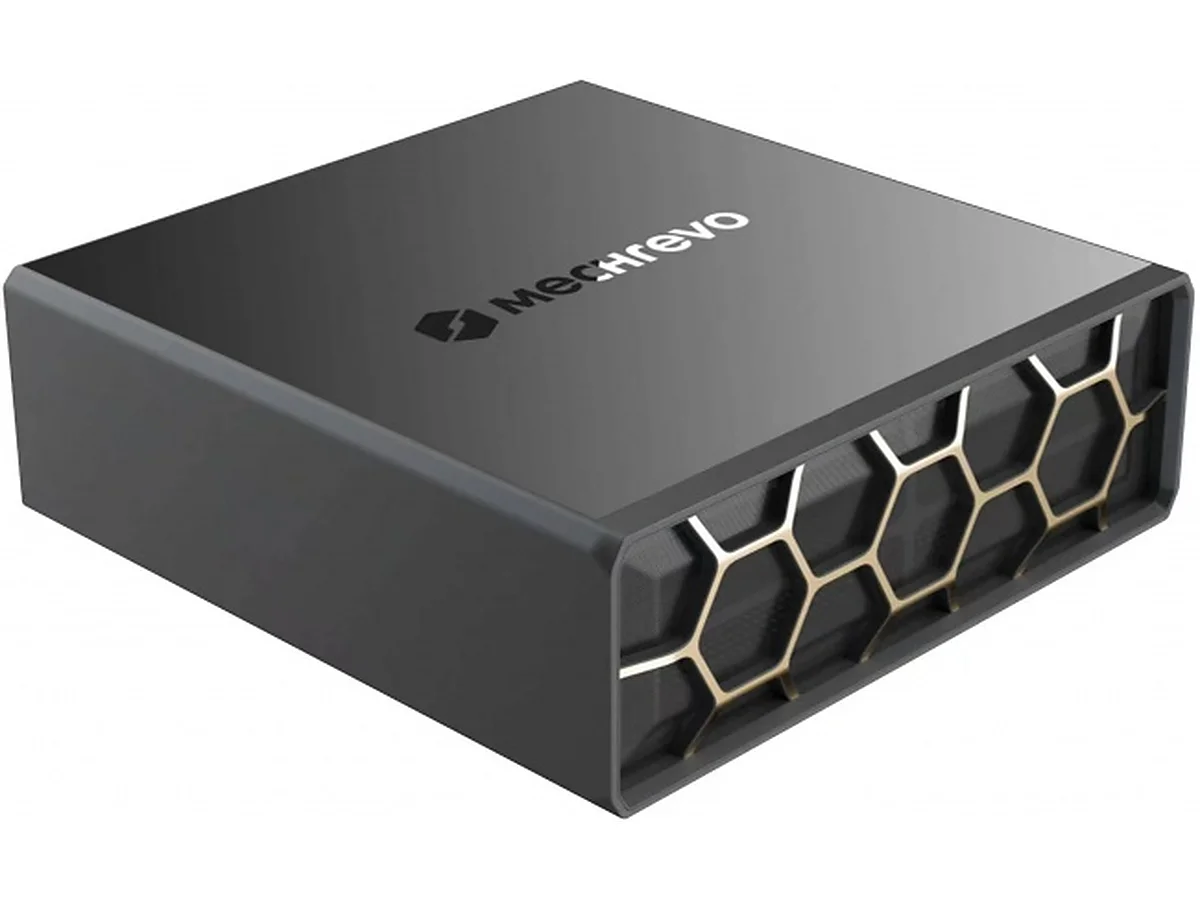 Foto: Divulgação
O que você acha? Você confia na ideia de usar SSD para ampliar a memória de modelos de IA em máquinas compactas? Para acompanhar mais, acesse nossa editoria.
Perguntas Frequentes
O Master Road X10 realmente consegue rodar modelos de 122 bilhões de parâmetros localmente?
O Master Road X10 tem como objetivo rodar modelos com até 122 bilhões de parâmetros usando a combinação da plataforma RTX Spark e a AI SSD proprietária. A fabricante afirmou suporte a modelos de 80, 120 e 122 bilhões, mas ainda não divulgou capacidade do SSD nem benchmarks públicos que comprovem desempenho sustentado em workloads reais.
Como funciona a AI SSD do Master Road X10 e quais ganhos foram relatados?
A AI SSD do Master Road X10 opera descarregando partes do modelo do DRAM para NAND e mantendo contextos processados para evitar recargas completas. Em apresentação, a Mechrevo relatou até 5,7× mais capacidade de modelos e aceleração de até 95% na etapa de prefill, além de testes internos que apontaram quase 2× de melhoria em inferência em um laptop Yaoshi 15 Air.
Quais são as principais limitações e dúvidas sobre a proposta do Master Road X10?
As principais dúvidas sobre o Master Road X10 são a ausência de benchmarks publicados, falta de informações sobre quantização de modelos e condições de teste, e o fato de NAND ser muito mais lento que DRAM. Isso significa que suportar modelos maiores não garante automaticamente latência ou throughput melhores sem otimização detalhada.