Marcos Antonio
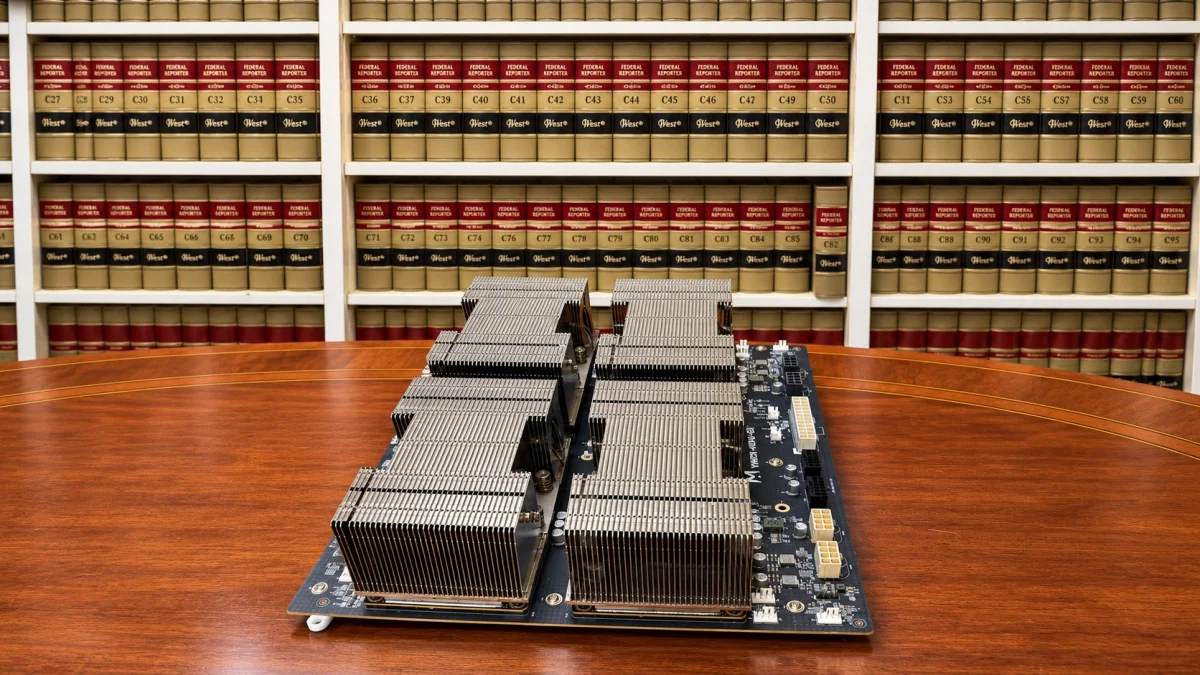
Nick Mermiges — o advogado que projetou um homelab de IA para manter arquivos jurídicos em hardware local elevou a aposta: a máquina que já rodava DeepSeek V4.1-Flash agora tem 1 TB de memória do sistema e passou a usar NVFP4 em grande parte das ativações, uma mudança que prioriza fidelidade do texto gerado em vez de máxima taxa de tokens por segundo.
Arquitetura, capacidade e números de referência
O núcleo do sistema são oito NVIDIA Tesla V100 SXM2 32 GB, organizadas em duas placas de quatro GPUs interligadas por NVLink, somando 256 GB de HBM2 no total. A comunicação entre as placas passa por PCIe 3.0, quatro PEX switches e cabos SlimSAS.
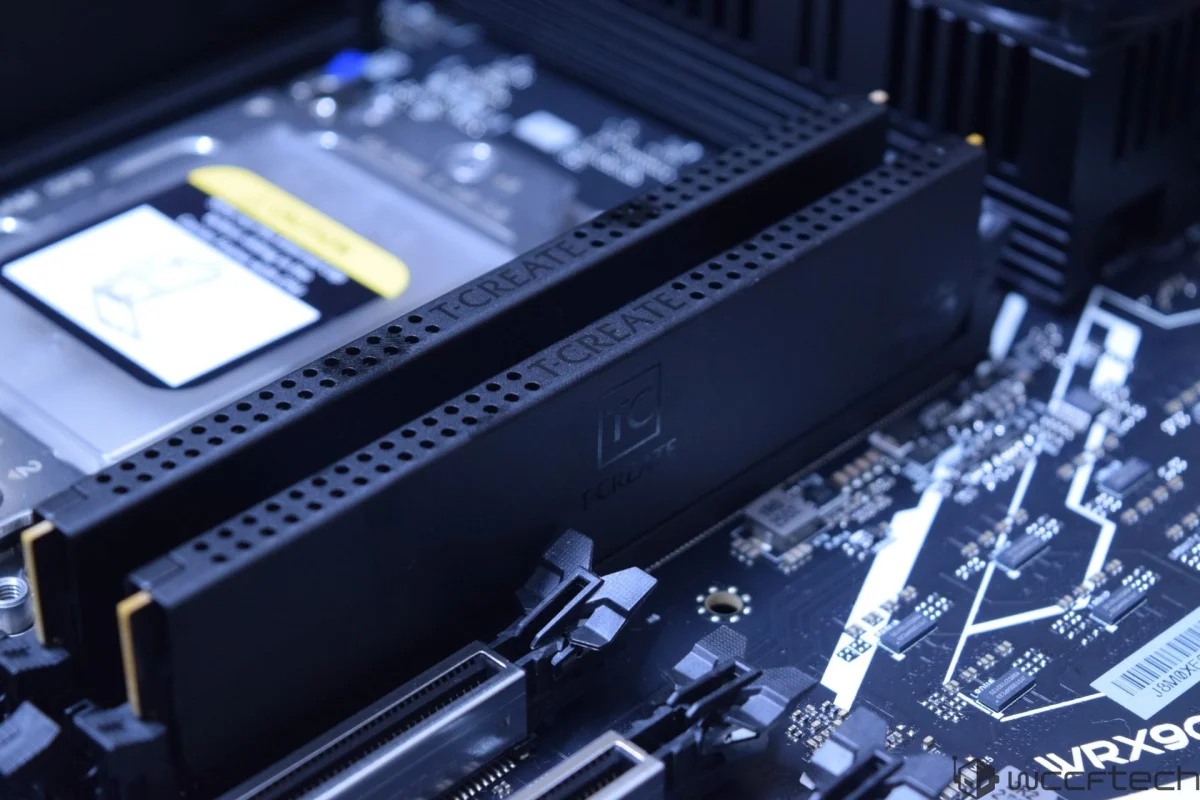
O host usa um AMD Threadripper PRO 3945WX e a configuração original trazia 256 GB de DDR4 ECC. Cada V100 oferece cerca de 900 GB/s de largura de banda HBM2; historicamente, um conjunto de quatro GPUs custou aproximadamente US$ 2.400, o que coloca o preço das duas placas em torno de US$ 4.800 na compra original.
O sistema roda localmente DeepSeek V4.1‑Flash com um modelo de cerca de 248,8 GB e usa aproximadamente 110 GB de tabelas de lookup em memória do sistema.
Atualização para NVFP4, impacto no throughput e recursos extras
A versão atualizada, batizada como Volta Max uPLIft, eleva frequentemente usados experts para a precisão NVFP4, mantendo representação de 2 bits nos demais. Com isso, cerca de 80–86% das ativações dos experts em testes de requisição única passaram a usar NVFP4, e a concordância de next‑token subiu de 92,2% para 95,1%, indicando ganho de fidelidade.
 Geleira Thwaites: recuos milenares somaram 1,5 m ao nível do mar
Leia a matéria completa →
 Bolsa Kindle: 1.288 livros gratuitos na edição que já terminou
Leia a matéria completa →
 ONS descarta apagão nacional e aponta risco de quedas locais
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
O custo dessa melhoria foi menor taxa de geração: o código passou de picos de 215 tokens por segundo em uma configuração anterior para cerca de 150–180 tok/s em testes individuais; dois pedidos concorrentes renderam 159 tok/s combinados. Para suportar fluxos de rascunho especulativo, a máquina recebeu ainda uma RTX 3090.
Além dos ganhos, o projeto enfrentou instabilidades: conector de alimentação queimado, erros de ECC e crashes possivelmente atribuídos a falhas na entrega de energia. Também é importante notar que a última ramificação de drivers a oferecer suporte total à arquitetura Volta é a R580.
Com otimizações e configuração personalizada, Mermiges estima que o servidor privado consegue substituir cerca de 50–60% de seus fluxos de trabalho anteriores com LLMs baseados na nuvem, um resultado que demonstra como hardware empresarial mais antigo ainda é útil quando emparelhado com ajustes de software.
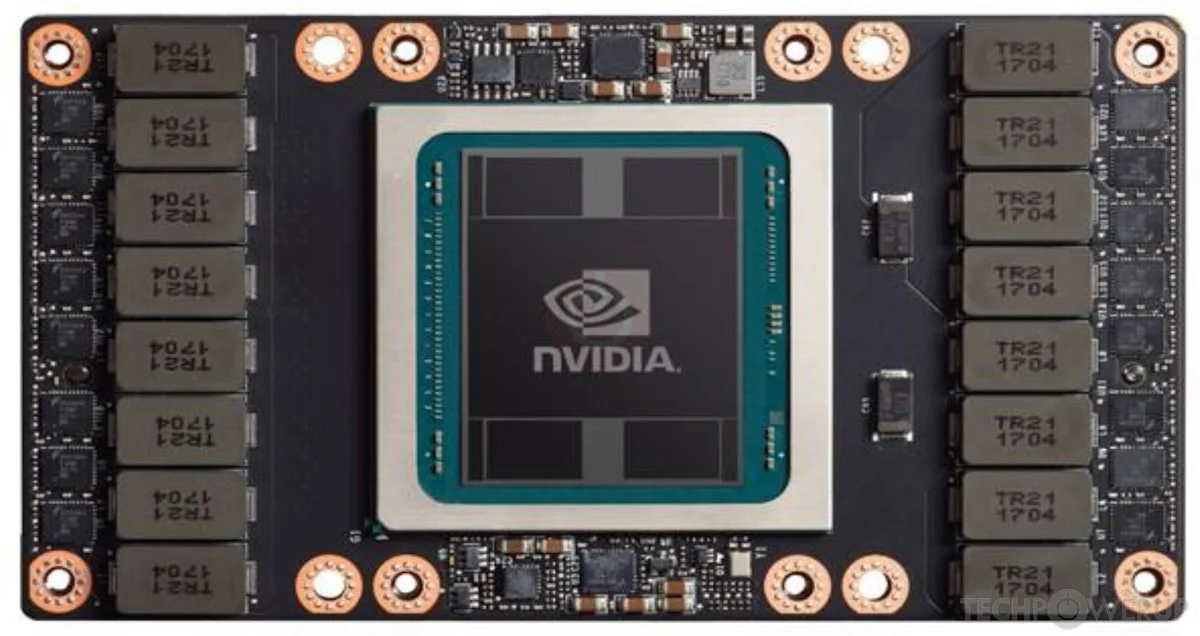 Foto: Divulgação
O que você acha? Você vê soluções locais como essa como alternativas viáveis para proteger documentos sensíveis? Para acompanhar mais, acesse nossa editoria.
Perguntas Frequentes
Como é a configuração do servidor de Nick Mermiges e quais GPUs ele usa?
O servidor de Nick Mermiges emprega oito NVIDIA Tesla V100 SXM2 32 GB divididas em duas placas de quatro GPUs interconectadas por NVLink, totalizando 256 GB de HBM2. O host roda um AMD Threadripper PRO 3945WX e a instalação original tinha 256 GB de DDR4 ECC, com várias otimizações de pipeline para inference local.
O que mudou com a atualização para NVFP4 e 1 TB de RAM no sistema de Nick Mermiges?
Com a atualização, Nick Mermiges aumentou a RAM do sistema para 1 TB, instalou uma RTX 3090 e elevou a maioria dos experts para a precisão NVFP4. Isso eleva a fidelidade (next‑token agreement de 92,2% para 95,1%) ao custo de redução de throughput para cerca de 150–180 tok/s em testes individuais.
Até que ponto o servidor de Nick Mermiges substitui fluxos de trabalho em nuvem?
O setup de Nick Mermiges foi estimado para cobrir aproximadamente 50–60% dos fluxos de trabalho LLM anteriores baseados em nuvem, rodando um modelo quantizado de cerca de 248,8 GB com cerca de 110 GB de tabelas de lookup em RAM do sistema, desde que se mantenha compatibilidade via a ramificação de driver que suporta Volta.