Leticia Rodrigues
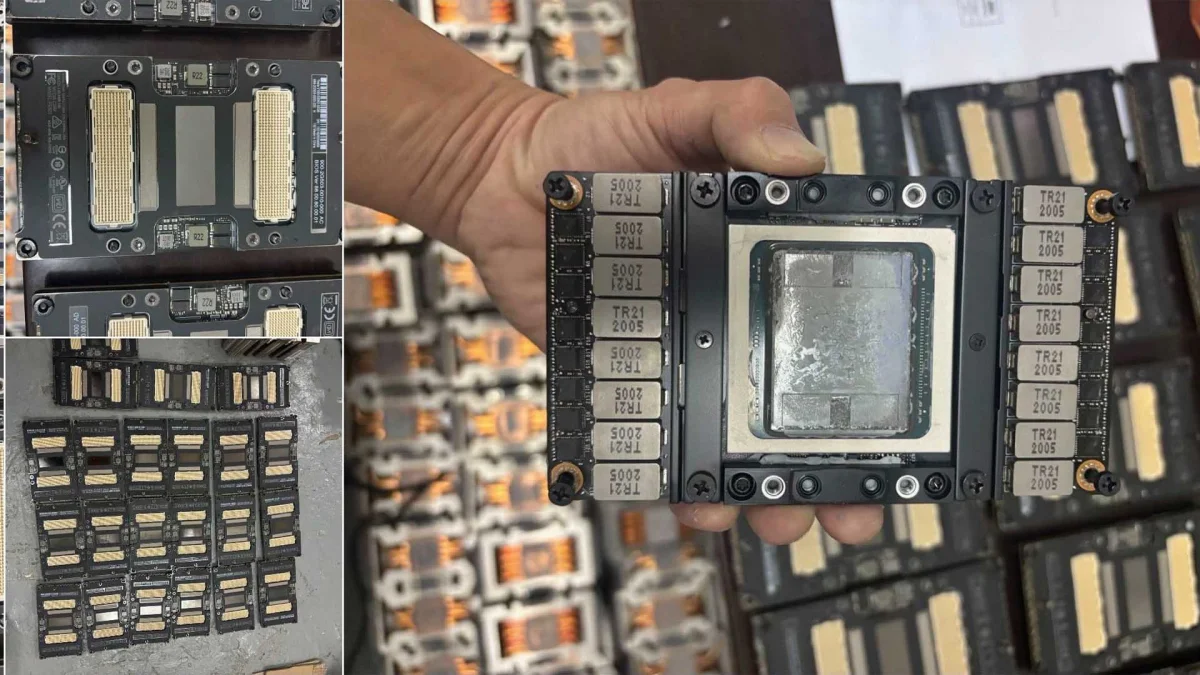
Tesla V100 — a GPU tem reaparecido no mercado como opção prática para montar rigs locais de modelos de linguagem, mas a boa notícia de disponibilidade vem acompanhada de um acréscimo de preço que exige decisão rápida de quem busca custo-benefício.
Disponibilidade, formatos e especificações que interessam a quem monta LLMs
A versão de 32 GB da Tesla V100 está sendo oferecida em duas formas físicas: o conector SXM2, pensado originalmente para servidores, e a variante PCIe 3.0 x16, que facilita a instalação em placas-mãe convencionais.
A placa traz 32 GB de HBM2 e banda de memória de aproximadamente 900 GB/s, o que a torna capaz de geração de tokens e processamento de prompts em níveis competitivos para modelos de grande porte sem exigir o investimento de GPUs topo de linha.
"O mercado está repentinamente saturado de placas V100 32 GB — há estoque suficiente, mas os preços subiram pelo menos US$200. A boa notícia? Com US$2.000 ainda é possível montar um rig local de LLM com desempenho realista."
Preço, cenários de uso e comparativo com alternativas mais caras
Apesar do aumento de cerca de US$200, a Tesla V100 segue sendo vista como a melhor relação custo-desempenho para entusiastas e times pequenos que querem rodar modelos sem gastar fortunas: um kit funcional pode sair por volta de US$2.000, segundo relatos de mercado.
 OLED MacBook Pro adia M7 e segue com M5 Pro/Max
Leia a matéria completa →
 NVIDIA lança Nemotron 3.5 Super VL 120B para agentes sempre‑ativos
Leia a matéria completa →
 Intel: imagens do die Xe3P revelam chip menor que Battlemage
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
O movimento de procura acontece num momento em que algumas GPUs de última geração estão menos acessíveis — por exemplo, a RTX 6000 PRO chegou a superar a faixa dos US$16.000 em meses recentes — o que empurra parte da demanda para soluções como a V100.
Além disso, combinações via NVLink que unem quatro Tesla V100 demonstraram aumentos de performance de até 230% em benchmarks com Qwen3.8-Flash-Next, mostrando que, em configuração correta, a V100 ainda compete com plataformas maiores.
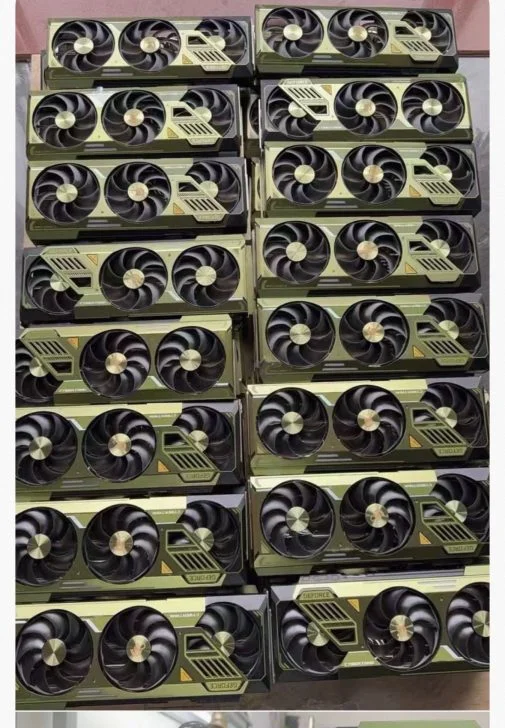 Foto: Divulgação
O que você acha? Você investiria em um rig local de IA com uma Tesla V100 sabendo do prêmio de preço? Para acompanhar mais notícias e análises, acesse nossa editoria.
Perguntas Frequentes
Quais versões e conectores a Tesla V100 de 32 GB tem disponível para uso em rigs?
A Tesla V100 de 32 GB está disponível nas variantes SXM2 e PCIe 3.0 x16, com o modelo SXM2 pensado originalmente para servidores e a versão PCIe adaptada para placas-mãe convencionais. A presença do conector PCIe facilita a adoção por quem não dispõe de placas com soquete SXM2.
Quanto está subindo o preço da Tesla V100 e por que isso afeta quem quer montar um LLM?
A Tesla V100 vem chegando ao mercado com um prêmio de cerca de US$200 sobre as cotações anteriores, reflexo da demanda por hardware para IA e da escassez de alternativas mais caras. Esse aumento impacta diretamente o custo final de um rig, que ainda pode ficar na faixa de US$2.000 para configurações básicas.
Que desempenho a Tesla V100 entrega em tarefas de inferência e que tipos de modelos ela roda?
A Tesla V100 entrega largura de banda de memória próxima a 900 GB/s e, quando combinada via NVLink em arranjos de quatro unidades, mostrou até 230% de ganho em benchmarks de Qwen3.8-Flash-Next; modificações com adaptadores SXM2-to-PCIe permitem rodar modelos de 27B parâmetros com desempenho prático em conjunto com GPUs como a RTX 4080.