 Rafael Menezes
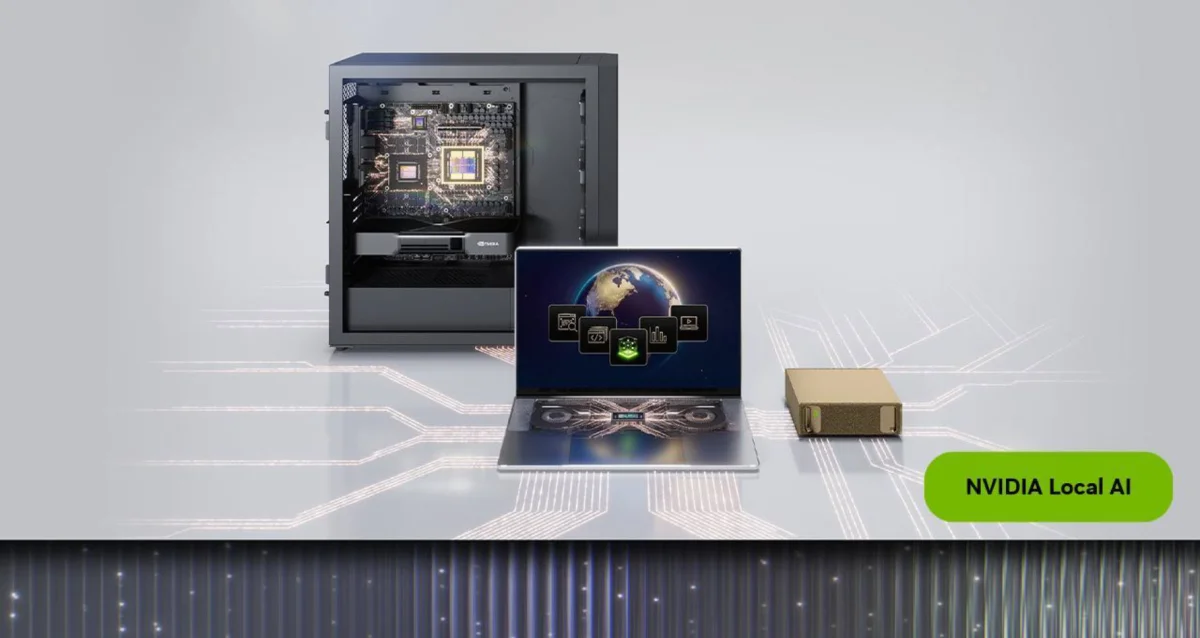
NVIDIA — a empresa elevou a escala e a capacidade dos seus sistemas locais de IA, abrindo o DGX Spark para configurações manuais de até oito unidades. A mudança entrega memória consolidada capaz de rodar modelos de classe frontier e amplia a viabilidade de desenvolvimento distribuído e agentes locais mais complexos.
Memória e clusters: o salto para 1 TB
Com a nova opção de cluster manual, o DGX Spark em configuração de 128 GB pode agora agrupar até 1 TB de memória unificada, enquanto a versão de 64 GB soma até 512 GB. Esse aumento facilita execuções com contextos longos, múltiplos agentes concorrentes e treinamento/distribuição de modelos maiores.
A NVIDIA também anunciou a disponibilidade do DGX Spark 64 GB comercialmente, com previsão de chegada em 23 de outubro, oferecendo uma porta de entrada adicional para desenvolvedores que trabalham com IA local.
O NVIDIA Sync Model Launcher estará disponível ainda neste mês. Ele simplifica o acesso a IA local em um único DGX Spark ou em um cluster: com alguns cliques o Model Launcher baixa um modelo e o contêiner adequado à configuração e conecta o modelo ao OpenCode. Também carrega DGX Spark Skills para solução de problemas, manutenção de dispositivos, acesso à documentação oficial e outras orientações de fluxo de trabalho. Além disso, a atualização de software do DGX Spark traz um novo Assistente de Wi‑Fi para alternar redes quando o sistema opera em modo appliance, e as DGX Spark Skills fornecem orientações práticas integradas ao NVIDIA Sync.
Acelerações de inferência e novos modelos locais
Os anúncios incluem suporte “day‑zero” a uma lista ampla de modelos, como Nemotron 3.5 Bolt 74B 24GB, Qwen3.8 27B e Gemma 4 26B‑A4B. A família também ganhou checkpoints otimizados para eficiência de RAM, projetados para deixar memória disponível para caches de KV em inferência local.
 Intel Core Ultra 9 4995HX lidera Nova Lake com 28 núcleos
Leia a matéria completa →
 Zephyrus G14: RMA devolve 16 GB em vez de 32 GB
Leia a matéria completa →
 Lenovo, HP e Dell mudam foco para empresas e driblam alta da memória
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Além disso, a empresa reportou ganhos de desempenho em cargas agenticas: o DGX Spark alcança até 30% mais velocidade em Qwen 3.8 27B, o DGX Station oferece cerca de 20% de melhoria em GLM 5.3 Flash, e o RTX PRO 6000 Blackwell atinge elevação de até 40% em Qwen 3.8 Flash‑Next. Essas métricas ampliam o leque de modelos executáveis em hardware local sem sacrificar responsividade.
Também foi apresentado o Recursive Flint, um modelo de codificação MoE de 40 bilhões com cerca de 2,5 bilhões de parâmetros ativos, otimizado para RTX Spark e capaz de mais de 220 tokens por segundo em sistemas RTX Spark de 64 GB.
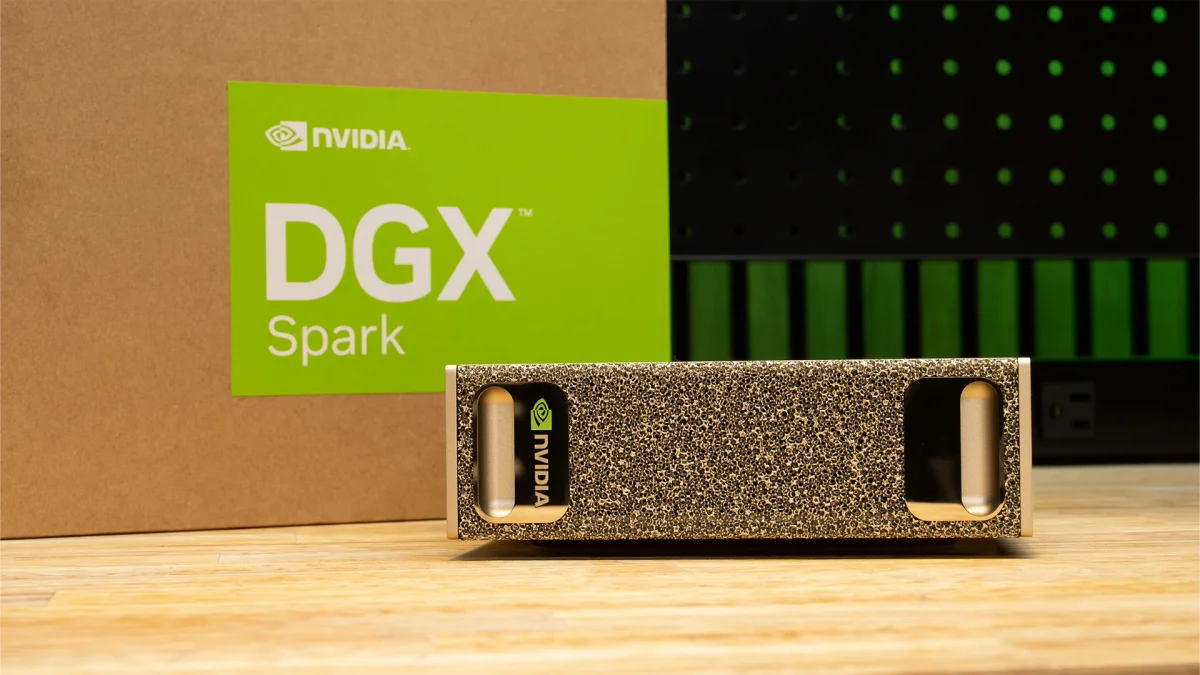 Foto: Divulgação
O que você acha? Essas mudanças tornam o desenvolvimento de IA local mais acessível ou vão concentrar poder em quem já tem infraestrutura? Para acompanhar mais, acesse nossa editoria.
Perguntas Frequentes
Como o DGX Spark da NVIDIA agora escala a clusters de 8 unidades e quanta memória isso oferece?
O DGX Spark da NVIDIA passa a suportar configuração manual em clusters de até oito sistemas, permitindo pooling de memória. Em prática, sistemas com módulos de 64 GB podem chegar a 512 GB agregados, enquanto configurações com 128 GB atingem até 1 TB de memória unificada, ampliando capacidade para modelos de grande contexto.
Quais modelos e quais ganhos de inferência foram anunciados para os sistemas DGX e RTX?
Os sistemas DGX e RTX da NVIDIA receberam suporte a modelos como Nemotron 3.5 Bolt 74B 24GB, Qwen3.8 27B e Gemma 4 26B‑A4B, além de checkpoints quantizados para RAM eficiente. Em testes, o DGX Spark mostrou 30% de ganho em Qwen 3.8 27B, DGX Station 20% em GLM 5.3 Flash e RTX PRO 6000 Blackwell 40% em Qwen 3.8 Flash‑Next.
O que é o Recursive Flint e qual desempenho ele entrega no RTX Spark?
O modelo Recursive Flint é uma proposta de codificação MoE da NVIDIA com 40 bilhões de parâmetros e cerca de 2,5 bilhões ativos em cada inferência, otimizada para RTX Spark. Em benchmarks de inferência local, o Recursive Flint supera 220 tokens por segundo em sistemas RTX Spark equipados com 64 GB, indicando resposta rápida para tarefas de codificação.