Marcos Antonio
PS5 — Um experimento técnico transformou o console em um servidor local capaz de carregar um modelo de linguagem de 27 bilhões de parâmetros, porém com compromissos severos de precisão e ocupação de memória. A façanha expõe limites práticos da arquitetura do console e os custos de recorrer a hacks para obter desempenho de IA fora do propósito original do aparelho.
Como o PS5 conseguiu rodar um 27B: truques e ganho de RAM
Para viabilizar a execução do Qwen3.8-27B no console, foi necessário converter trabalho do CPU para a GPU e usar um port nativo de llama.cpp que roda sobre Vulkan. A estratégia inicial restringia a memória disponível a apenas 6 GB, mas um port otimizado com o driver RADV elevou esse teto para aproximadamente 11,4 GB.
Com essa janela ampliada, foi possível carregar uma versão extremamente quantizada do Qwen3.8-27B, identificada como Qwen3.8-27B-UD-IQ2_XXS, cujo armazenamento de pesos ficou em torno de 6,8 GB ao usar representações de cerca de 2 bits por peso. A técnica reduz drasticamente requisitos, mas compromete qualidade e raciocínio do modelo.
Para quem quiser consultar informações oficiais sobre a plataforma, é possível visitar a página da PlayStation.
 Intel Nova Lake‑S: placa LGA 1954 mostra DDR5‑6400 e suporte a Wi‑Fi 7
Leia a matéria completa →
 Volante para PC: G29 é o ponto de partida com três pedais
Leia a matéria completa →
 AMD EPYC Verano: até 192 núcleos com memória LPDDR5X como trunfo
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
A versão quantizada do Qwen3.8-27B ocupou cerca de 6,8 GB de pesos, teve janela de contexto de 64K e chegou a usar 91% da memória disponível no console.
Desempenho, limitações e custos do método
Em termos de geração, o Qwen3.8-27B rodando nessa configuração atingiu 20,9 tokens por segundo, com GPU a 100% e CPU em cerca de 2%. Modelos menores se comportaram muito melhor: Gemma 4 E4B alcançou 61 tok/s e Llama 3.2 3B chegou a 124 tok/s.
O consumo de energia medido foi de 86 W e a temperatura reportada ficou em torno de 54 °C, indicando que o console se manteve relativamente frio diante da carga máxima de GPU. Ainda assim, o principal custo é a degradação qualitativa do modelo devido à quantização intensa; em precisão de 16 bits, o Qwen3.8-27B exigiria algo como 54 GB de memória, impossível em configuração padrão de console.
Além das perdas de qualidade, transformar o PS5 em app nativo exige jailbreak, o que anula garantias de fabricante e pode levar a banimentos em serviços online. Essas consequências práticas são um trade-off relevante para quem busca rodar modelos maiores em hardware doméstico.
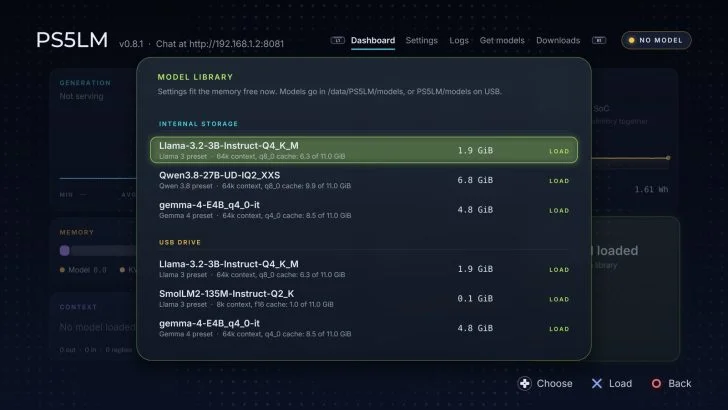 Foto: Divulgação
O que você acha? Você considera aceitável comprometer qualidade e garantia para rodar modelos de IA no PS5? Para acompanhar mais, acesse nossa editoria.
Perguntas Frequentes
O PS5 pode realmente rodar um modelo de linguagem com 27 bilhões de parâmetros?
O PS5 conseguiu rodar uma versão do modelo Qwen3.8-27B, mas em forma fortemente quantizada: o arquivo de pesos ficou em cerca de 6,8 GB e a implementação usou uma janela de contexto de 64K, consumindo aproximadamente 91% da memória disponível após otimizações que elevaram o limite para 11,4 GB.
Quais velocidades de geração foram alcançadas ao rodar modelos no PS5?
O PS5 atingiu 20,9 tokens por segundo ao executar Qwen3.8-27B com GPU a 100% e CPU em 2%; modelos menores tiveram desempenho bem superior, com Gemma 4 E4B em 61 tok/s e Llama 3.2 3B em 124 tok/s. O consumo total registrado ficou em 86 W e a temperatura em torno de 54 °C.
Quais são as principais limitações e riscos de usar o PS5 como servidor local de IA?
O PS5 fica limitado pela memória de 16 GB GDDR6 (largura de banda de 448 GB/s), o que obriga a quantização extrema — 16-bit exigiria cerca de 54 GB para Qwen3.8-27B. Além da perda de qualidade, o processo requer jailbreak, que anula a garantia do console e pode resultar em penalidades online.