Dimitri Lares
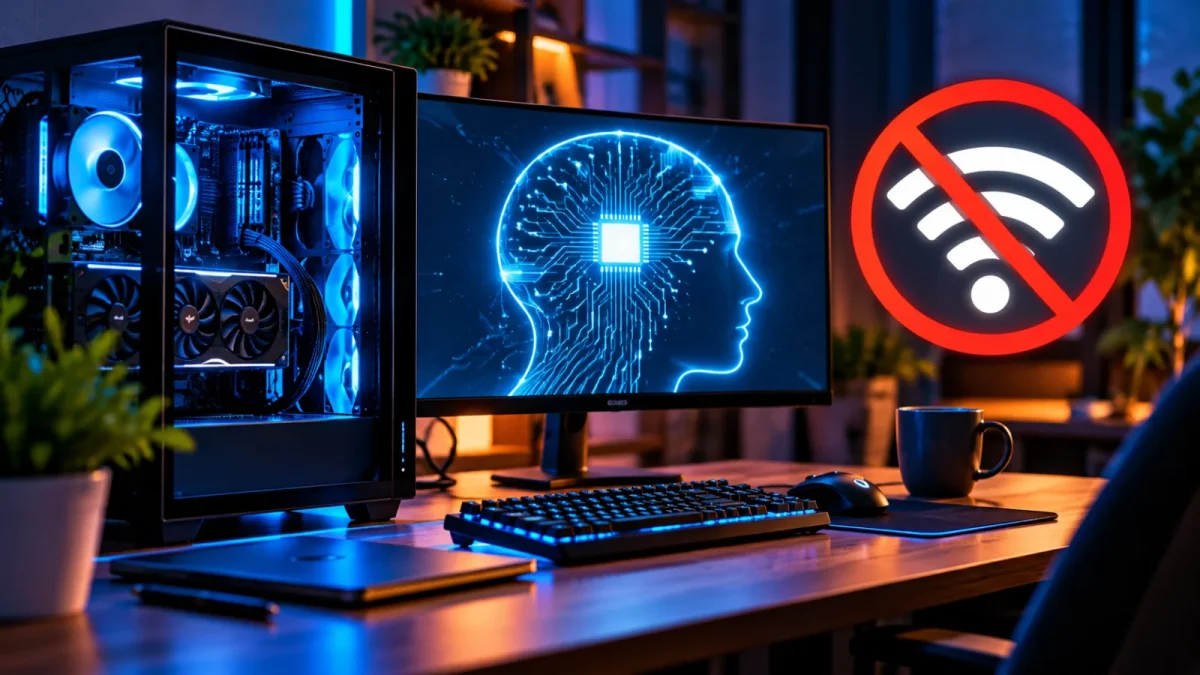
IA local — rodar modelos no próprio computador já é realidade prática e muda a forma como você protege dados, trabalha sem conexão e controla quais modelos ficam disponíveis. A vantagem imediata é privacidade e autonomia; a consequência é a necessidade de planejar espaço em disco, memória e os downloads antes de ficar offline.
Como instalar e testar offline com LM Studio e Ollama
Dois caminhos comuns são uma interface gráfica para iniciantes e uma ferramenta de linha de comando para quem integra APIs locais. Instale o aplicativo desejado, faça o download do modelo enquanto estiver conectado e confirme que todos os runtimes necessários foram obtidos.
No caso do Ollama, um exemplo prático é executar o comando de pull para uma versão específica do modelo — por exemplo, ollama pull qwen3.5:4b — e depois iniciar a sessão com ollama run qwen3.5:4b. Teste o funcionamento desligando o Wi‑Fi e repetindo uma pergunta simples para checar se a inferência ocorre sem rede.
Resposta rápida: um PC com 8 GB de RAM pode começar com modelos pequenos; 16 GB ampliam as opções; 32 GB oferecem mais conforto para modelos maiores; e uma GPU dedicada acelera, mas não é obrigatória.
Que PC você precisa e como otimizar desempenho
O requisito varia conforme o modelo e sua quantização. Para testes iniciais, 8 GB de RAM permitem executar modelos muito compactos (por exemplo, Llama 3.2:1b ou variantes quantizadas). Com 16 GB, modelos de 3B–4B ficam mais viáveis; 32 GB suportam opções maiores e contextos mais longos.
 M5 MacBook Air: todos os modelos com US$200 de desconto
Leia a matéria completa →
 Motorola Signature chega com 256 GB por R$ 5.999
Leia a matéria completa →
 Lotomania: 0 ganhadores na faixa principal e prêmio estimado R$ 10,3 mi
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
GPU não é exigência absoluta: muitos modelos executam por CPU, mas uma GPU com VRAM suficiente acelera a geração. Atenção à diferença entre RAM do sistema e VRAM da placa de vídeo; Macs com Apple Silicon usam memória unificada. Para poupar memória, prefira versões GGUF quantizadas (4 bits) quando disponíveis e reduza a janela de contexto.
O que você acha? Você já tentou rodar IA local no seu PC ou pretende testar em breve? Para acompanhar mais, acesse nossa editoria.
 Foto: Divulgação
Perguntas Frequentes
Como instalar e usar a IA local com LM Studio ou Ollama para trabalhar sem internet?
A IA local pode ser instalada com LM Studio ou Ollama; primeiro baixe o instalador do programa e, enquanto estiver online, faça o download do modelo desejado (por exemplo, qwen3.5:4b). Depois de confirmar que o modelo e os runtimes foram baixados, desligue a conexão e repita uma pergunta para checar que a inferência ocorre inteiramente no PC.
Que configuração de PC é necessária para rodar Qwen 3.5 4B no computador?
Qwen 3.5:4b costuma exigir aproximadamente 3–4 GB de download na variante citada e recomenda-se pelo menos 16 GB de RAM para uso confortável; 8 GB serve só para modelos bem compactos. Uma GPU com VRAM ajuda, mas não é obrigatória: muitos testes funcionam por CPU; ajustar a quantização e reduzir o contexto são formas práticas de economizar memória.
Posso conversar com PDFs e documentos sem internet usando IA local?
A IA local permite consultar PDFs e documentos desde que o programa ofereça recurso de recuperação local (RAG) ou LocalDocs; por exemplo, algumas ferramentas suportam indexação de arquivos e conversas com base nesses textos. PDFs digitalizados podem exigir OCR, e a precisão depende da extração do conteúdo e da qualidade do modelo local.