 Vinicius Balbino
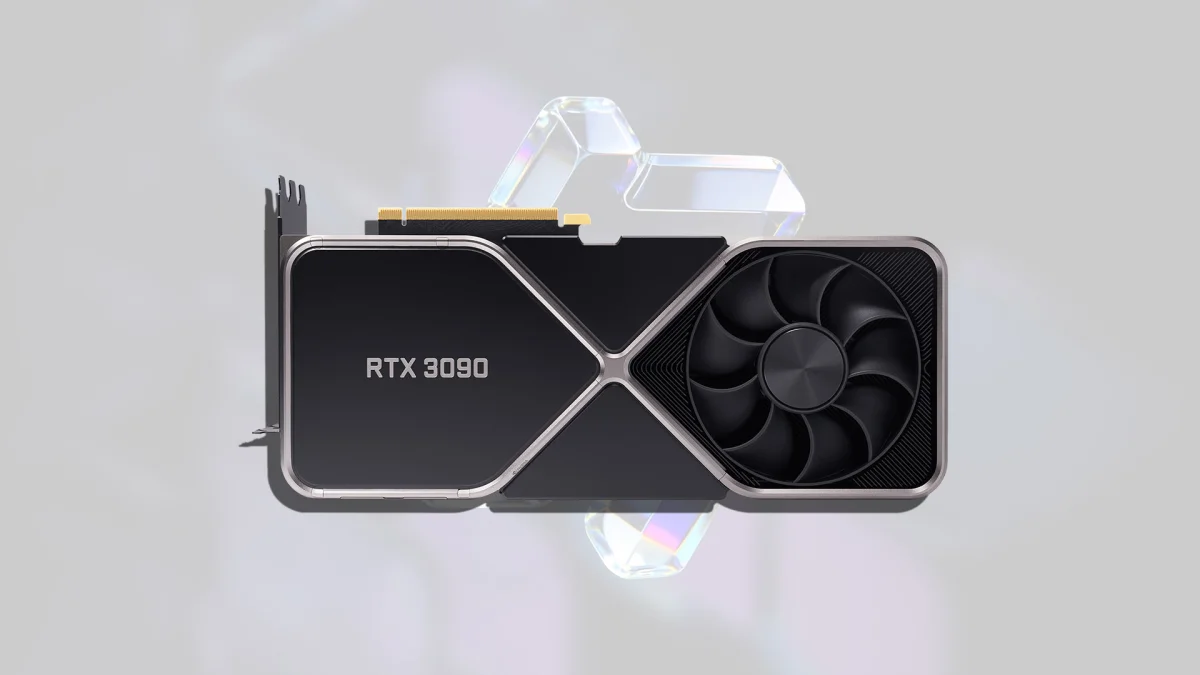
RTX 3090 — O salto de desempenho relatado pode transformar GPUs mais antigas em alternativas viáveis para inferência de grandes modelos, reduzindo a necessidade de hardware mais caro em algumas tarefas específicas.
Como o salto de até 4,6× foi obtido
O ganho não veio de overclock nem de trocar a GPU: veio de otimizações no motor de inferência. O gargalo identificado é a leitura das "weights" na memória — a GPU fica ociosa esperando dados, não calculando.
Para contornar isso, o desenvolvedor aplicou decodificação especulativa: um drafter rápido propõe várias previsões e o modelo principal as verifica de uma só vez. Ajustes no MTP elevaram o desempenho inicial a cerca de 114 tok/s; depois vieram DFlash2 (palpites de sete tokens) e um "lookup" que aproveita repetições no diálogo, subindo para 138 tok/s e, em documentos longos, até 382 tok/s.
"Qwen3.8-27B passou de 82 para 381 tokens por segundo em uma única RTX 3090; o aumento veio de otimizações da pilha de inferência."
Limitações, custos e cenários práticos
A RTX 3090 tem 24 GB de VRAM, o que ainda restringe casos de uso; além disso, a verificação maior ocupa metade dos slots de requisição e consome cerca de 8.000 tokens de contexto por etapa, tornando o modo opcional em muitas situações.
 ASUS ROG Astral RTX 5090: presente de US$12.000 emociona casamento
Leia a matéria completa →
 DLSS 5: novo modelo liberado por mods entrega até 40% mais FPS
Leia a matéria completa →
 NVIDIA DLSS chega a GPUs Radeon via mod que ativa Ray Reconstruction
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
O formato compacto de memória usado para ampliar a janela de contexto chegou a 138.696 tokens, mas duplica o tempo de leitura inicial de um documento — ideal quando se carrega um texto grande uma vez e faz muitas perguntas depois. Em bate-papo comum, o modo mais agressivo roda por volta de 133 tok/s, enquanto fora de tarefas de texto repetido fica cerca da metade do MTP.
O que você acha? Você considera essas otimizações suficientes para manter uma RTX 3090 útil em tarefas de LLM ou prefere migrar para hardware mais recente? Para acompanhar mais, acesse nossa editoria.
 Foto: Divulgação
Perguntas Frequentes
Como a RTX 3090 conseguiu ir de 82 para 382 tokens por segundo com Qwen3.8-27B?
A RTX 3090 alcançou o salto ao combinar decodificação especulativa com múltiplos drafters: MTP levou a ~114 tok/s, DFlash2 propôs 7 tokens por vez e um "lookup" explorou repetições, resultando em picos de 382 tok/s em tarefas de documento. O método mantém precisão semelhante, com 96,5% em um benchmark de matemática.
Quais são as limitações da RTX 3090 ao rodar modelos 27B como Qwen3.8-27B?
A RTX 3090 enfrenta dois limites principais: 24 GB de VRAM e o custo de buscar pesos na memória apesar dos 936,2 GB/s de largura de banda. Otimizações podem aumentar a janela de contexto, mas consomem 8.000 tokens por etapa e dobram o tempo de leitura inicial em formatos compactos, restringindo casos de uso.
Em que cenários as otimizações na RTX 3090 fazem mais sentido?
A RTX 3090 beneficia-se dessas otimizações especialmente em tarefas que repetem texto ou consultam longos documentos: em um trabalho com 25.000 tokens, o motor chegou a 382 tok/s porque muitas previsões eram aceitas; quando se carrega um documento uma vez e faz muitas perguntas, o formato compacto compensa o tempo extra de leitura.